

16 ноября мы провели день в московском Кластере «Ломоносов» на ИИ КОНФе — практической конференции о том, как бизнес применяет нейросети. Шесть залов, больше 100 спикеров, больше 1000 участников. Документерра участвовала официально: наша команда работала на стенде на выставке и слушала доклады.
Мы ехали туда с вопросом, откуда ИИ-ассистенты и агенты в компаниях берут знания. Ответ прозвучал раньше, чем мы ожидали: уже на первой панели. А к концу дня стало ясно, что на нём держится почти каждый успешный кейс.
Пользоваться ИИ и внедрить ИИ — разные вещи
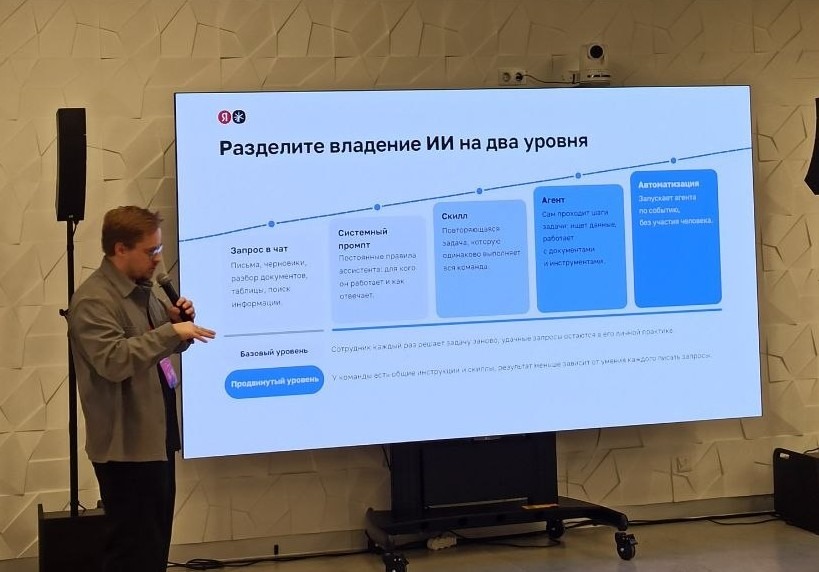
Дмитрий Ерёменко из Яндекс Практикума начал доклад с фразы, которую слышит от руководителей постоянно: «У нас все уже пользуются ИИ». Формально это так. По данным BCG, которые он привёл, 74 из 100 рядовых сотрудников работают с ИИ каждый день или несколько раз в неделю. В 2025 году таких было 51, в 2018-м — 20.
Но пользуются часто несистемно и втихую. Сотрудники путают агента с ассистентом, удачные запросы остаются в личной практике, а руководитель считает, что раз он купил подписку и раздал доступы, команда уже работает с ИИ. На деле в команде обычно есть около 10% энтузиастов, которые собрали себе агентов, и все остальные.
Ерёменко предлагает смотреть на владение ИИ как на лестницу: запрос в чат, системный промпт, скилл, агент и автоматизация, при которой агент запускается по событию без участия человека. Первая ступень — базовый уровень: сотрудник каждый раз решает задачу заново. Начиная со второй, у команды появляются общие инструкции и скиллы, и результат меньше зависит от того, насколько хорошо каждый умеет писать запросы.
Прямо во время конференции мы спросили подписчиков нашего Telegram-канала, на какой ступени этой лестницы они сейчас. Проголосовали 9 человек, так что это не исследование, а скорее срез. Но картина совпала с тем, о чём говорил Ерёменко. Пятеро из девяти пока пишут запросы в чат. Трое пользуются общими скиллами команды, один настроил системный промпт. Собственного агента не собрал никто, и автоматизации без участия человека тоже ни у кого нет.
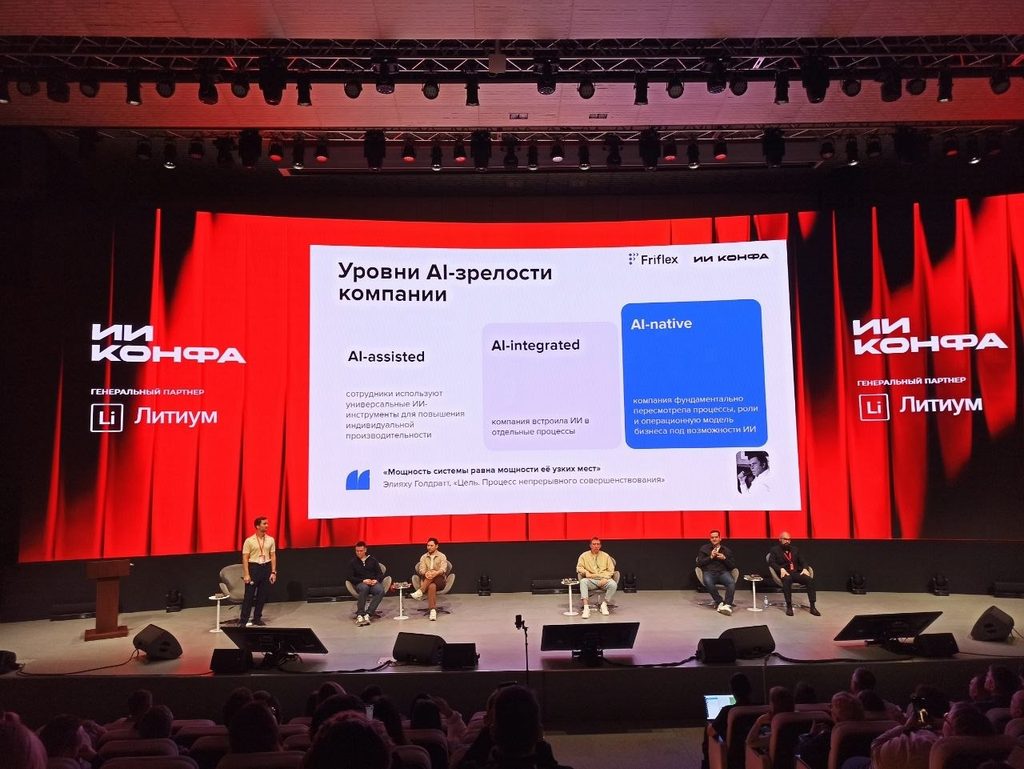
На панели «AI-native компания» Петр Чернышев из Friflex показал похожую шкалу, только для компаний. AI-assisted — сотрудники используют универсальные инструменты для личной продуктивности. AI-integrated — ИИ встроен в отдельные процессы. AI-native — компания пересобрала процессы, роли и бизнес-модель под возможности ИИ. Истинно AI-native компаний на рынке, по его словам, пока нет, «сколько бы ни надували щёки». Многие дошли до AI-integrated и упёрлись в узкие места.
При этом несколько спикеров независимо друг от друга назвали 2026 год переломным для внедрения агентов в своих компаниях.
Шаг номер один — текст
На той же панели прозвучал совет, ради которого мы, в общем-то, и приехали. Первый шаг к внедрению ИИ — сделать так, чтобы звонки, письма, чаты и обсуждения превращались в текст и хранились в единой базе знаний. Доступ к ней нужен и сотрудникам, и агентам, чтобы все работали в одном контексте.
Этот тезис повторяли и дальше. В списке практик Friflex есть корпоративная AI-платформа с RAG, интеграциями, разными моделями, ролями и правами. А в GearGames так устроили работу на самом деле: о них ниже.
Для нас это главное наблюдение конференции. База знаний перестаёт быть архивом, куда люди изредка заглядывают. Агент без неё работает вслепую: у него нет ни контекста команды, ни фактов о продукте.
Сначала описать, потом автоматизировать
Если агент должен делать работу так же, как человек, кто-то должен объяснить ему, как эту работу делает человек. Спикеры называли это по-разному.
Один подход — «цифровые двойники». Сотрудников просят описать свои процессы для агентов, потому что лучше них эти процессы не знает никто. Описывать предлагают буквально, вплоть до того, в каком порядке человек смотрит на статью, чтобы решить, важная она или нет: заголовок, картинка, краткое описание.
Другой — матрица ролей. Все роли в компании (у одного из участников их 1500) сначала помечают красным: везде пока работают люди. Потом каждую роль перекрашивают в зелёный, если её перевели на ИИ, или в жёлтый, если рассмотрели и решили, что пока рано. KPI руководителей — сколько ролей перекрашено. С таким темпом согласны не все: звучал и более осторожный вариант, когда агенты сначала получают процессы, где можно безопасно ошибаться, а автономность им расширяют постепенно.
Чтобы всё это не превратилось в набор разрозненных экспериментов, спикеры советовали создать центр экспертизы. Это выделенные люди, которые умеют собирать агентов, ходят к владельцам процессов, вместе с ними ищут, что автоматизировать, следят за единым стеком и прогрессом. Руководителю, и особенно генеральному директору, отводили роль драйвера внедрения. И начинать советовали с себя: тот, кто автоматизировал собственную работу, лучше понимает, с чем столкнутся сотрудники.
У Ерёменко нашлась мысль, которая объясняет, почему всё это так трудно: главная сложность внедрения — отсутствие процессов, в которые его встраивать. Небольшую компанию ИИ впервые заставит эти процессы описать.
На панели «Человек + AI-агенты» добавили ещё одно условие. Автоматизация приживается, только если сотрудник доверяет модели и уверен, что она сделает всё по его правилам и так, как сделал бы он сам. За каждую автоматизацию при этом должен отвечать конкретный человек. А скиллы советовали пересматривать примерно раз в месяц и давать ИИ больше свободы по мере того, как растут модели.
«По его правилам» работает, только если правила где-то записаны. Скилл, системный промпт, цифровой двойник — по сути это документация, только читатель у неё другой.
Агенты, которые уже работают
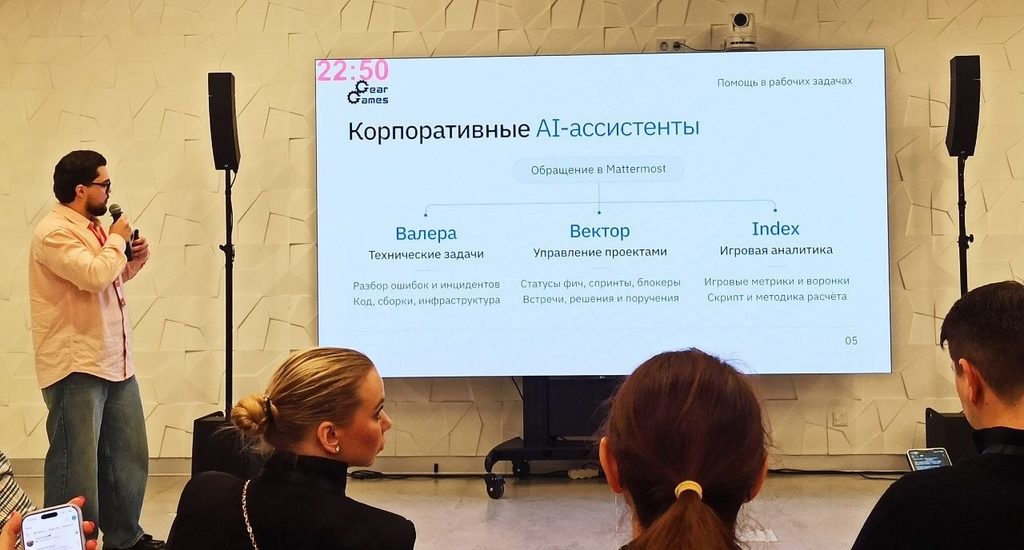
Самый наглядный кейс дня показал Руслан Ахметзянов из GearGames. У компании три корпоративных ассистента, и обращаются к ним прямо в рабочем мессенджере.
Валера отвечает за технические задачи: разбирает ошибки и инциденты, код, сборки, инфраструктуру. В одном из показанных случаев игрок оплатил два набора в игре, а получил один. Поддержка спросила Валеру. Через 4 минуты он нашёл в логах ошибку Redis при обработке именно этого платежа. Вопрос передали серверной команде, и через две минуты инженер подтвердил сбой. Программистов и DevOps для такого разбора не понадобилось.
Самое ценное в этом кейсе — то, чего Валера сделать не смог. Проверить статус в боевой базе данных он не мог, потому что доступа к ней у него нет, и прямо об этом написал. По словам спикера, добиться от агента такого честного ответа вместо правдоподобной выдумки было непросто.
Вектор ведёт проекты. Встречи записываются и расшифровываются, а Вектор вместе с контекстом задач из YouTrack выделяет из расшифровки решения, поручения и риски. К каждому пункту он прикладывает цитату-основание, заводит задачи и создаёт встречи в календаре. Задачи в компании вручную не заводит никто. Если на встрече что-то не дорешили, Вектор сначала пробует выяснить вопрос в чате и только потом ищет слот для звонка. Третий агент, Index, считает игровые метрики и воронки и показывает методику расчёта.
Все три агента работают потому, что им есть на что сослаться: расшифровки, логи, задачи, код.
Цена ошибки и почему ревью документации нельзя убирать
Перед запуском агента на панели советовали задать себе три вопроса: какова цена ошибки, какова цена промедления и можно ли откатить то, что сделал агент. Дмитрий Голиков из ЛИТИУМ добавил: «У вас всё получится, но не с первого раза».
С ценой ошибки мы столкнулись у себя. Наши тестировщики подключили Claude к документации Документерры через MCP-сервер опубликованной документации, и модель пишет по ней тест-кейсы и автотесты, в том числе для фич, которые тестировщик сам ещё не видел. Подробно об этом мы рассказали на Хабре: «Мы отдали документацию Claude, и он начал писать нам автотесты».
Самый важный вывод из этого опыта касается как раз ошибок. Неточность в документации переходит в тесты, и тесты начинают закреплять неверное поведение. В итоге все тесты зелёные, а продукт тем временем уходит от задуманного. Откатить такое сложно, потому что ошибку никто не видит. Поэтому в нашей цепочке два обязательных ручных ревью: документации и тест-кейсов. Если по документации работают агенты, вычитывать её становится ещё важнее, а не наоборот.
Нейросети как новый канал продаж
Софья Мартихина из «Арнест Юнирусь» рассказала, как компания добивается, чтобы нейросети рекомендовали её бренды, и привела цифры, которые стоит знать всем, кто отвечает за публичный контент.
По исследованию «Ашманова и партнёров» за июнь 2026 года, на решение о покупке совет ИИ-сервиса влияет у 32% потребителей, а мнение значимых людей — у 17%. В косметике и парфюмерии совет нейросети влияет ещё сильнее, на 36%. По данным Mediascope, еженедельная аудитория чата с Алисой AI в 2026 году составляет 31 млн человек, у ChatGPT в России — 8,2 млн, у ГигаЧата — 5,7 млн. И 12% запросов к Алисе AI, по данным Яндекса, связаны с поиском и покупкой товаров.

Нейросеть отвечает по тому, что нашла в открытом доступе. Для B2B и технически сложных продуктов один из лучших таких источников — пользовательская документация: в ней подробно и без маркетинговых обещаний написано, что продукт умеет, какие у него ограничения и как решить конкретную задачу. Если документация публичная, структурированная и актуальная, нейросеть пересказывает её. Если её нет, о продукте расскажут конкуренты и случайные форумы.
Что мы услышали у стенда
За день у стенда мы поговорили со многими, кто сейчас внедряет ИИ у себя, и картина сложилась довольно чёткая.
Внутренняя база знаний, по которой может отвечать бот, нужна почти всем. Это прямое продолжение того, о чём говорили в залах: компании хотят, чтобы сотрудники и агенты работали в одном контексте.
Клиентской документацией интересуются реже. Но интерес появляется, когда собеседник понимает, что его клиенты уже спрашивают о продукте нейросети, а те отвечают по тому, что нашли в сети. AI-поиск становится для компаний поводом наконец навести порядок в пользовательской документации.
Что это значит для документации
Мы уезжали с конференции с ощущением, что у документации появились новые читатели, причём требовательные. Раньше её открывали клиенты, когда что-то не получалось. Теперь по ней работают внутренние агенты, ей проверяют тесты, а нейросети пересказывают её покупателям.
Отсюда несколько практических шагов для тех, кто внедряет ИИ:
- Соберите знания в одном месте. Расшифровки встреч, решения, регламенты и описания продукта, разбросанные по чатам и папкам, агенту недоступны.
- Описывайте процессы так, чтобы их понял новичок. Инженер, который знает слишком много, пропускает важные детали. Текст для новичка оказывается полнее, и агенту он подходит лучше.
- Пишите ограничения, а не общие слова. «Файл обрабатывается» агенту ничего не даёт. «Файлы больше 50 МБ отклоняются с ошибкой 413» — уже проверяемый факт.
- Не убирайте ревью. Ошибка в документации, по которой работает агент, размножается быстрее, чем ошибка в документации, которую читает человек.
- Откройте пользовательскую документацию. Если клиенты спрашивают о продукте нейросети, у нейросети должно быть, что им ответить.
В Документерре мы работаем над тем, чтобы документация подходила обоим читателям: людям и агентам. ИИ Помощник отвечает читателям по опубликованной документации, а MCP-сервер опубликованной документации даёт агентам доступ к ней с учётом прав.
ЧаВо
Практическая конференция о применении ИИ и нейросетей в бизнесе. В 2026 году она прошла 16 ноября в Москве, в Кластере «Ломоносов». Программа шла в шести залах по трекам: ИИ для руководителей, маркетинг и контент, продажи и клиентский сервис, HR, бэк-офис, мастер-классы.
AI-first — правило, по которому новую задачу сначала пробуют отдать агенту и только если не получилось — человеку. AI-native — компания, которая с самого начала построена вокруг ИИ или полностью пересобрала под него процессы, роли и бизнес-модель. Петр Чернышев из Friflex считает, что истинно AI-native компаний на рынке пока нет.
Спикеры чаще всего называли три шага: собрать коммуникации и знания компании в текстовом виде в единой базе знаний, назначить команду, которая отвечает за внедрение, и описать процессы, которые планируется автоматизировать.
Агент отвечает и действует на основе того контекста, который ему доступен. Если решения, регламенты и описания продукта хранятся в головах сотрудников и личных переписках, агенту не на что опереться, и он либо ошибается, либо выдумывает.
Нейросети вроде Алисы AI и ГигаЧата отвечают по информации из открытых источников. Публичная, структурированная и актуальная документация даёт им точные факты о продукте. Без неё нейросеть опирается на сторонние и не всегда точные материалы.
Можно, если в цепочке есть ручная проверка. Ошибки в документации переходят в результаты работы агента, поэтому документацию и то, что агент сделал на её основе, должен проверять человек.

